大模型部署中的 PD 分离是指什么?
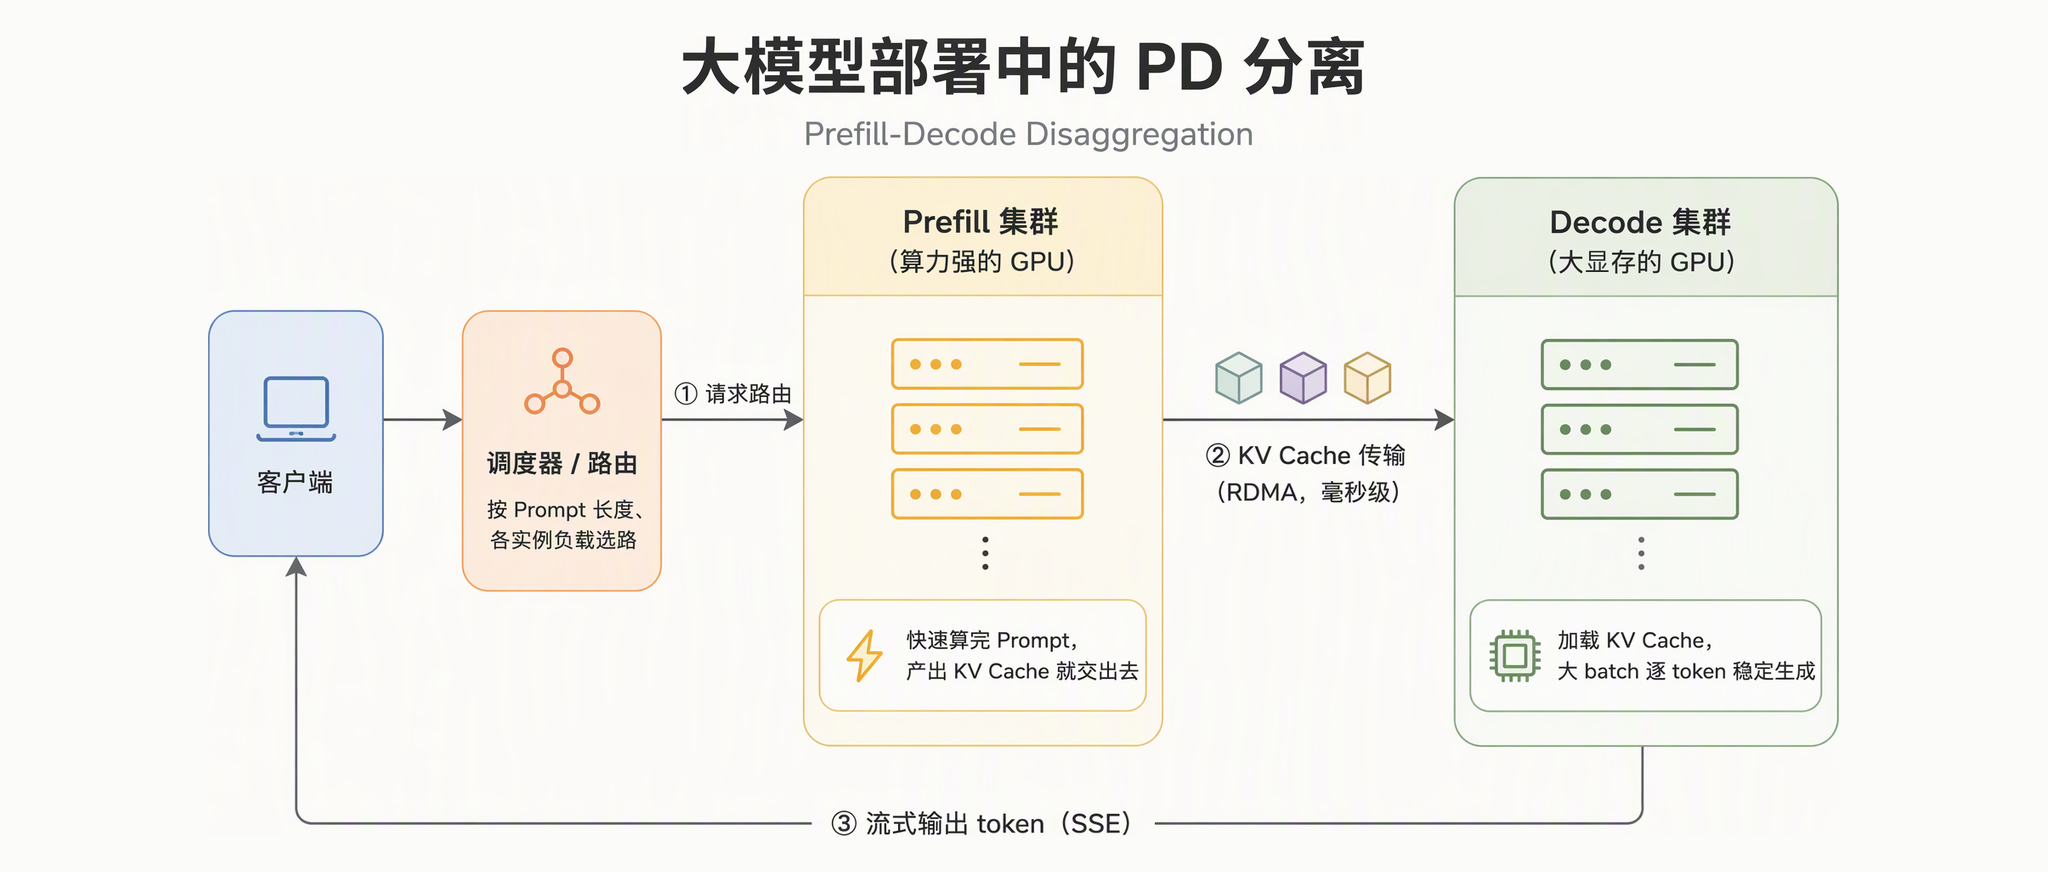
训练好的大模型,本地部署通常直接用 Ollama 一体式部署即可;以 7B 级别的量化模型为例,性能好的机器输出速度可以达到 200+ token/s。但在工程上,大规模、高并发的生产环境往往需要将 Prefill 过程和 Decode 过程分开部署,也就是我们常说的 PD 分离。本文从大模型的基础开始,详细介绍大模型的 PD 分离,以及为什么需要 PD 分离。
token、自回归、KV Cache
这里是大模型中的三个基础概念。
先说 token:大模型不直接处理汉字或单词,它处理 token,可以理解成"文本碎片"。一个英文单词大约拆成 1~2 个 token,一个汉字大约也是 1~2 个。你调 API 时按 token 计费,宣传里的"支持 128K 上下文"说的也是 token 数。
自回归:模型生成一段话的方式是这样的:
第 1 步:输入"法国的首都是哪里"     → 输出"巴"
第 2 步:输入"法国的首都是哪里巴"   → 输出"黎"
第 3 步:输入"法国的首都是哪里巴黎" → 输出"。"
……直到输出结束符
每一步的输出都要拼回输入,再算下一步。这个循环叫自回归(autoregressive)。所以逐字输出不是产品风格,是物理约束。

不难看出,按照自回归的生成方式,在生成第 1000 个 token 时,模型需要"看到"前面 999 个。而且随着已生成 token 数的增多,下面每步都把历史全部重算一遍的话,计算量会爆炸。
工程上的解法是 KV Cache。KV 是 Key 和 Value 的缩写。每个 token 过模型时都会算出这两组中间结果。把它们存在显存里。下一步直接读缓存,只算新 token 的那一份。原理可以类比 Java 中的 用 StringBuilder 拼接字符串而不是 += 拼字符串一样,仅追加增量。
代价是显存。拿 7B 模型举例:32 层、隐藏维度 4096、FP16 精度。算下来,每个 token 的 KV Cache 约 0.5 MB。一个 4K 上下文的请求,光 KV Cache 就要吃掉约 2 GB。一张卡先装模型参数,剩下的显存才轮到 KV Cache。一台机器能放多少 KV Cache,决定了它能同时服务多少请求。
记住这一点:KV Cache 是大模型服务的第一资源约束。后面讲的很多事情都是被它逼出来的。
Prefill 阶段和 Decode 阶段
现在看一个请求进来后,模型实际干了什么。分成两步:
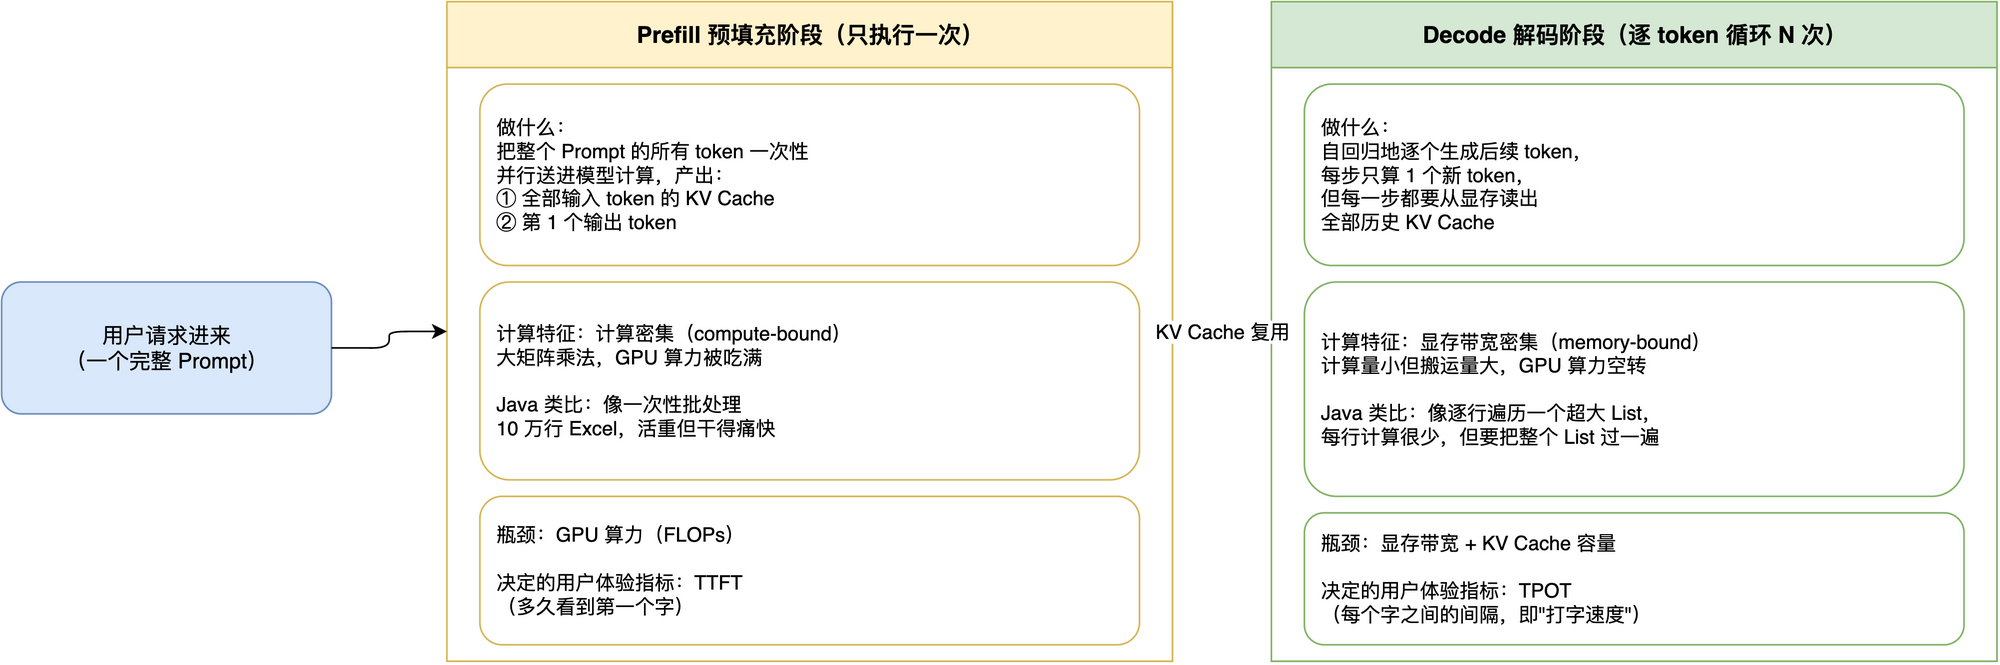
- 预填充(Prefill)阶段:只执行一次。 它把整个 prompt 一次性并行送进模型。所有输入 token 的 KV Cache 一次算完,第一个输出 token 也顺手产出。几千个 token 同时过模型,相当于一次巨大的矩阵乘法。GPU 算力被吃得满满的。这个阶段是计算密集(compute-bound)型,瓶颈在 GPU 算力;
- Decode(解码)阶段,也叫推理阶段,逐 token 循环 N 次。 它进入自回归循环,每步只算 1 个新 token。听起来轻松,但每步都要把全部历史 KV Cache 从显存读出来。每步计算量小,搬运量却大。GPU 算力大部分时间在空等数据。这叫显存带宽密集(memory-bound)。瓶颈在显存带宽,也在 KV Cache 容量。
两个阶段的资源瓶颈不一样,如果是采用传统的一体式部署,在 Decode 阶段会让昂贵的 GPU 资源大量空转。PD 分离通俗地讲就是为了把这两个资源需求不一样的人物放到两个机器上,Prefill 机器把 KV Cahche 算好了之后传给 Decode 机器。最大程度地榨干 GPU 的计算资源。
从后端角度可以这么类比:Prefill 像一次性批处理十万行 Excel:活很重,但机器全程满负荷。Decode 像遍历一个 10 GB 的 List,每行只做个 +1。瓶颈不在算,在读。
这两个阶段的工作量分别决定了用户在前端感受到的两个指标:

- TTFT(Time To First Token):发完问题,多久看到第一个字。也叫首 token 延迟,由 Prefill 决定。
- TPOT(Time Per Output Token):每个字之间隔多久。也叫逐 token 延迟,由 Decode 决定。
一般来讲,TTFT 超过 2 秒,用户就明显觉得系统迟钝。TPOT 稳定在 50 毫秒以内,读起来就感觉不到卡。这两个指标是衡量大模型服务质量的核心,后面所有架构决策都围着它们转。
传统部署的问题
早期的部署方式是一体化。Prefill 和 Decode 跑在同一批 GPU 上。推理引擎(比如 vLLM、SGLang)把它们混进同一个 batch 调度。
麻烦在于,这两个阶段想要的硬件不一样,甚至相反。一个要算力,一个要显存带宽和容量。让一批机器同时伺候好两个阶段,结果只会互相拖累。好比一个人既做批处理任务,又维护长连接服务。
具体会出三个问题。
- 互相干扰。长 prompt 的 Prefill 是重计算突发。它插进 batch,会把同批正在 Decode 的请求全部拖慢。用户侧看到的就是回答流到一半卡了一下,也就是 TPOT 抖动。
- 资源错配。Prefill 想要算力强的卡,Decode 想要显存大、带宽高的卡。买同一种卡,总有一侧在用不合适的硬件干活。
- 扩缩容浪费。RAG 场景输入长、输出短,压力在 Prefill。代码生成和推理模型输出长,压力在 Decode。一体化部署只能整体加机器。流量画像稍微偏一点,就有一部分 GPU 在空转。
PD 分离
PD 分离,全称 Prefill-Decode Disaggregation。
如上面所述,思路很直接:两个阶段性格不合,就拆成两套机器。Prefill 用一批 GPU,Decode 用另一批。KV Cache 走高速网络搬过去。

对照图下半部分,一个请求的旅程是这样的:
- 请求先进调度器。调度器按 prompt 长度和实例负载选路,把请求发给一台 Prefill 实例。
- Prefill 集群快速算完 prompt,把产出的 KV Cache 交出去。
- KV Cache 通过 RDMA 搬到 Decode 实例。RDMA 让网卡直接读写对方显存,绕过 CPU。几 GB 的数据,毫秒级就能搬完。
- Decode 实例加载 KV Cache,开着大 batch 逐 token 稳定生成。结果以流式方式推给用户。
整条链路里,真正的技术核心在第 3 步。一个长 prompt 的 KV Cache 可能有好几 GB。搬运要是花了几十上百毫秒,分离省下的时间就全赔进去了。所以这套方案严重依赖高速互联。NIXL、Mooncake KV Store、LMCache 是主流的几个实现。
传输还带来了新的故障模式,工程上要有预案。传输一变慢,TTFT 就飙高。但这时 Prefill 耗时是正常的,排查很容易走偏。传输失败时,不能让请求直接报错。标准做法是回退为本机重算 Prefill,降级成一体化路径把请求跑完。
优势和局限
优势很明显:两个阶段互不干扰,TTFT 和 TPOT 可以分别优化。尾延迟(P99)明显改善。Mooncake 论文报告过 75% 量级的吞吐提升。硬件各配各的:Prefill 用算力卡,Decode 用大显存卡。单位 token 成本得以下降。两个集群独立扩缩容、独立发布。一边出问题不会拖垮另一边,故障域也切开了。
缺点在引入的 KV Cache 传输是新的故障点。RDMA 网卡、传输引擎都得纳入监控,这条链路在一体化时代根本不存在。调度器变成关键单点。它要感知负载,还要知道每份 KV Cache 存在哪。自身的高可用必须保障。容量规划也要算两盘账。算法不难:
Prefill 实例数 = 输入 token 速率 ÷ Prefill 单实例吞吐
Decode 实例数 = 输出 token 速率 ÷ Decode 单实例吞吐
需要注意的是:短 prompt、短输出的场景不适合走分离。这类请求 KV Cache 小、算得快。走分离反而亏,多一跳网络,传输开销比省下的时间还多。
所以生产部署通常是混合架构。大部分流量走 PD 分离集群,小请求由调度层留在一体化实例池里跑掉。判断标准不复杂:比一下 KV 传输时间和能省下的排队、干扰成本,哪头大走哪边。
这也是调度器在 PD 分离架构里地位高的原因。它不只是做负载均衡,还要做请求分类和路由决策。
参考文献
本文引用的论文
- Ruoyu Qin et al. Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving(Moonshot AI / 清华大学,FAST 2025 最佳论文)。文中"吞吐提升 75%"的数据出自这篇论文:https://arxiv.org/abs/2407.00079
PD 分离方向的其他代表工作
- Pratyush Patel et al. Splitwise: Efficient generative LLM inference using phase splitting(Microsoft,ISCA 2024)。最早系统论证"按阶段拆分 + 异构硬件各配各的"的工作:https://arxiv.org/abs/2311.18677
- Yinmin Zhong et al. DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving(OSDI 2024)。从 TTFT / TPOT 双 SLO 出发推导两个阶段的资源分配与并行策略:https://arxiv.org/abs/2401.09670
文中提到的系统与开源实现
- vLLM 与 PagedAttention(SOSP 2023):论文 https://arxiv.org/abs/2309.06180,代码 https://github.com/vllm-project/vllm
- SGLang(RadixAttention):论文 https://arxiv.org/abs/2312.07104,代码 https://github.com/sgl-project/sglang
- NVIDIA Dynamo,原生支持 PD 分离的数据中心级推理编排框架:https://github.com/ai-dynamo/dynamo
- NIXL(NVIDIA Inference Xfer Library),Dynamo 默认的 KV Cache 传输库:https://github.com/ai-dynamo/nixl
- Mooncake 开源实现,含 Transfer Engine 与 Mooncake Store:https://github.com/kvcache-ai/Mooncake
- LMCache,跨引擎共享的 KV Cache 层:论文 https://arxiv.org/abs/2510.09665,代码 https://github.com/LMCache/LMCache
本站文章遵循 Apache 2.0 开源协议,转载请注明出处,商业化出版请联系本站管理员(页面底部)
 鄂公网安备42098402000265号